第 1 章 · Python 数据模型
Guido 对语言设计美感的把握令人惊叹。我见过许多出色的语言设计者,他们能造出理论上很美、但没人愿意用的语言。Guido 属于少数派:他造出的语言,理论上稍逊一点美,但写起程序来是一种享受。 —— Jim Hugunin,Jython 的创造者,AspectJ 的共同作者,.Net DLR 的架构师
Python 最好的品质之一是它的一致性。用过一段时间之后,你就能对没见过的特性做出有依据、且通常正确的猜测。
不过,如果你先学了别的面向对象语言,可能会觉得 len(collection) 这种写法很怪,为什么不是 collection.len()?
这个看似古怪的地方只是冰山一角。看懂了它,就拿到了理解一切所谓 “Pythonic” 的钥匙。这座冰山叫 Python 数据模型(Python Data Model)——也就是我们用来让自己的对象和语言里各种惯用法配合得好的那套 API。
你可以把数据模型理解成“把 Python 当框架”的描述。它把语言本身的积木块的接口定死:序列、函数、迭代器、协程、类、上下文管理器等等。
用框架的时候,我们写的大量代码是“等着被框架调用”的方法。用 Python 数据模型写新类也是一样:Python 解释器会调用特殊方法来完成基本的对象操作,这些操作通常由特殊语法触发。
特殊方法的名字总是前后各两个下划线。比如语法 obj[key] 靠 __getitem__ 支持。解释器要求值 my_collection[key] 时,实际调用的是 my_collection.__getitem__(key)。
当我们希望自己的对象去支持并与下面这些语言基本结构交互时,就去实现特殊方法:
- 集合(collections)
- 属性访问
- 迭代(包括
async for形式的异步迭代) - 运算符重载
- 函数与方法调用
- 字符串表示与格式化
- 用
await做异步编程 - 对象创建与销毁
- 用
with/async with语句管理的上下文
魔法方法与 dunder
Section titled “魔法方法与 dunder”“magic method”(魔法方法)是特殊方法的口语叫法。那具体某个方法,比如 __getitem__,怎么念?作者兼老师 Steve Holden 教我说 “dunder-getitem”。“dunder” 就是 “double underscore before and after”(前后双下划线)的简写。所以特殊方法也叫 dunder 方法。
《Python 语言参考》的 “Lexical Analysis” 一章提醒过:“任何地方使用 __*__ 形式的名称,只要不属于明文记载的用法,都可能在没有警告的情况下失效。”
本章新增内容
Section titled “本章新增内容”这一章相比第一版改动很少,因为它只是介绍相当稳定的 Python 数据模型。最明显的改动是:
- 支持异步编程和其他新特性的特殊方法,加进了“特殊方法总览”的表格。
- 新增图 1-2,展示“集合 API”里特殊方法的用法,包含 Python 3.6 引入的
collections.abc.Collection抽象基类。 - 本书第二版统一改用 Python 3.6 引入的 f-string。它比老的
str.format()和%运算符更易读、通常也更方便。
提示:仍然值得用 my_fmt.format() 的一种场景是——格式字符串的定义位置和真正做格式化的位置不在一起。比如 my_fmt 是多行的,更适合作成常量;或者它来自配置文件、来自数据库。这些需求真实存在,但出现频率不高。
一副 Pythonic 的扑克牌
Section titled “一副 Pythonic 的扑克牌”例 1-1 很简单,但展示了只实现 __getitem__ 和 __len__ 两个特殊方法的威力。
import collections
Card = collections.namedtuple('Card', ['rank', 'suit'])
class FrenchDeck:    ranks = [str(n) for n in range(2, 11)] + list('JQKA')    suits = 'spades diamonds clubs hearts'.split()
    def __init__(self):        self._cards = [Card(rank, suit) for suit in self.suits                                        for rank in self.ranks]
    def __len__(self):        return len(self._cards)
    def __getitem__(self, position):        return self._cards[position]
首先注意用 collections.namedtuple 造了一个表示单张牌的小类。namedtuple 用来构造“只有一堆属性、没有自定义方法”的对象类,就像一条数据库记录。这里它给牌提供了好看的表示:
>>> beer_card = Card('7', 'diamonds')>>> beer_cardCard(rank='7', suit='diamonds')但这个例子的重点是 FrenchDeck 类。代码很短,但很有料。
第一,和任何标准 Python 集合一样,deck 能响应 len(),返回牌的张数:
>>> deck = FrenchDeck()>>> len(deck)52取出特定的牌(比如第一张、最后一张)也很容易,靠的是 __getitem__:
>>> deck[0]Card(rank='2', suit='spades')>>> deck[-1]Card(rank='A', suit='hearts')要写个方法随机抽一张吗?不用。Python 已经有从序列里随机取元素的函数 random.choice,直接用在 deck 上就行:
>>> from random import choice>>> choice(deck)Card(rank='3', suit='hearts')>>> choice(deck)Card(rank='K', suit='spades')>>> choice(deck)Card(rank='2', suit='clubs')到这里已经看到用特殊方法借力数据模型的两个好处:
- 你的类的使用者不必去记标准操作对应的任意方法名。(“怎么拿到元素个数?是
.size()、.length()还是别的?”) - 更容易吃到 Python 标准库的红利、不用重复造轮子,比如直接用
random.choice。
还有更好的。因为我们的 __getitem__ 把活转交给了 self._cards 的 [] 运算符,deck 自动支持切片。
拿一副新牌的前三张,以及从下标 12 开始、每次跳 13 张,正好挑出所有 A:
>>> deck[:3][Card(rank='2', suit='spades'), Card(rank='3', suit='spades'),Card(rank='4', suit='spades')]>>> deck[12::13][Card(rank='A', suit='spades'), Card(rank='A', suit='diamonds'),Card(rank='A', suit='clubs'), Card(rank='A', suit='hearts')]只实现了 __getitem__,deck 还顺便变成可迭代的:
>>> for card in deck: # doctest: +ELLIPSIS... print(card)Card(rank='2', suit='spades')Card(rank='3', suit='spades')Card(rank='4', suit='spades')...反向迭代也可以:
>>> for card in reversed(deck): # doctest: +ELLIPSIS... print(card)Card(rank='A', suit='hearts')Card(rank='K', suit='hearts')Card(rank='Q', suit='hearts')...doctest 里的省略号:本书的 Python 控制台输出,只要可能,都是从 doctest 里抓出来的,以保证准确。输出太长时,省掉的部分用省略号 (...) 标出,就像上面最后一行。这种情况下作者加了 # doctest: +ELLIPSIS 让 doctest 通过。你在交互式控制台里试这些例子时,这些 doctest 注释完全可以不写。
迭代常常是隐式的。如果一个集合没有 __contains__ 方法,in 运算符就退化为顺序扫描。所以 in 也能用在 FrenchDeck 上,因为它可迭代:
>>> Card('Q', 'hearts') in deckTrue>>> Card('7', 'beasts') in deckFalse排序呢?常见的牌序规则是:先比点数(A 最大),再比花色,顺序是黑桃(最大)、红心、方块、梅花(最小)。下面这个函数按该规则给牌打分,梅花 2 返回 0,黑桃 A 返回 51:
suit_values = dict(spades=3, hearts=2, diamonds=1, clubs=0)
def spades_high(card):    rank_value = FrenchDeck.ranks.index(card.rank)    return rank_value * len(suit_values) + suit_values[card.suit]
有了 spades_high,就能把整副牌按点数从小到大列出来:
>>> for card in sorted(deck, key=spades_high): # doctest: +ELLIPSIS... print(card)Card(rank='2', suit='clubs')Card(rank='2', suit='diamonds')Card(rank='2', suit='hearts')... (46 cards omitted)Card(rank='A', suit='diamonds')Card(rank='A', suit='hearts')Card(rank='A', suit='spades')FrenchDeck 虽然隐式继承自 object,但它的大部分能力不是继承来的,而是靠数据模型加组合得来的。实现 __len__ 和 __getitem__ 之后,FrenchDeck 表现得像标准 Python 序列,于是白拿核心语言特性(迭代、切片)和标准库(random.choice、reversed、sorted)。而因为用了组合,__len__ 和 __getitem__ 可以把全部工作转交给 self._cards 这个 list 对象。
那洗牌呢? 就目前实现而言,FrenchDeck 不能洗牌,因为它是不可变的:牌和它们的位置都改不了,除非破坏封装直接操作 _cards。第 13 章我们会加一个一行的 __setitem__ 方法来解决。
特殊方法是怎么被使用的
Section titled “特殊方法是怎么被使用的”关于特殊方法,第一件要知道的事:它们是给 Python 解释器调用的,不是给你调用的。
你不写 my_object.__len__(),而写 len(my_object)。如果 my_object 是用户定义类的实例,Python 就会去调你实现的 __len__。
但对 list、str、bytearray 这类内置类型,或者 NumPy 数组这类扩展,解释器会走捷径。用 C 写的变长集合包含一个叫 PyVarObject 的结构体,里面有个 ob_size 字段保存元素个数。所以如果 my_object 是这些内置类型之一,len(my_object) 直接读 ob_size 字段的值,比调用方法快得多。
更多时候特殊方法的调用是隐式的。比如语句 for i in x: 实际上会触发 iter(x),而 iter(x) 可能去调 x.__iter__()(如果有),或者像 FrenchDeck 那样用 x.__getitem__()。
正常情况下,你的代码里不该有很多直接调用特殊方法的地方。除非你在做大量元编程,否则你应该实现特殊方法,而不是显式调用它们。用户代码里唯一经常被直接调用的特殊方法是 __init__——用来在自己的 __init__ 里调用父类的初始化器。
如果你确实需要调用某个特殊方法,通常更好的做法是调用相关的内置函数(len、iter、str 等)。这些内置函数会调对应的特殊方法,但往往还提供别的服务,而且对内置类型来说比方法调用更快。(详见第 17 章 “Using iter with a Callable”。)
接下来的小节会看到特殊方法最重要的几种用途:
- 模拟数值类型
- 对象的字符串表示
- 对象的布尔值
- 实现集合
模拟数值类型
Section titled “模拟数值类型”有一些特殊方法让用户对象能响应 + 之类的运算符。第 16 章会详细讲,这里通过另一个简单例子继续说明特殊方法的用法。
我们要实现一个表示二维向量的类——就是数学和物理里的欧几里得向量(见图 1-1)。
提示:内置的 complex 类型也能表示二维向量,但我们的类可以扩展成 n 维向量。第 17 章会做这件事。
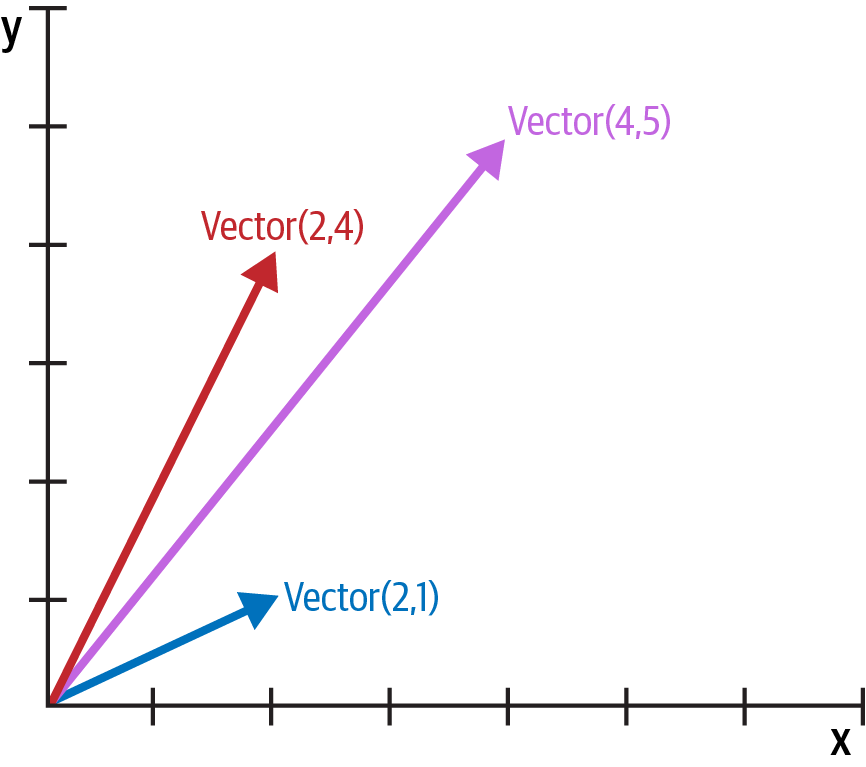
先写一段模拟的控制台会话,作为这个类 API 的设计目标,之后还能当 doctest 用。下面测试的就是图 1-1 里的向量加法:
>>> v1 = Vector(2, 4)>>> v2 = Vector(2, 1)>>> v1 + v2Vector(4, 5)注意 + 运算符产生一个新的 Vector,并且在控制台上以友好的格式显示。
内置函数 abs 对整数和浮点数返回绝对值,对复数返回模。为保持一致,我们的 API 也用 abs 计算向量的模:
>>> v = Vector(3, 4)>>> abs(v)5.0我们还能实现 * 运算符做标量乘法(把向量乘一个数,得到方向相同、模也按比例放大的新向量):
>>> v * 3Vector(9, 12)>>> abs(v * 3)15.0例 1-2 是 Vector 类,用 __repr__、__abs__、__add__、__mul__ 四个特殊方法实现了上述操作。
"""vector2d.py: a simplistic class demonstrating some special methods
It is simplistic for didactic reasons. It lacks proper error handling,especially in the ``__add__`` and ``__mul__`` methods.
This example is greatly expanded later in the book.
Addition::
    >>> v1 = Vector(2, 4)    >>> v2 = Vector(2, 1)    >>> v1 + v2    Vector(4, 5)
Absolute value::
    >>> v = Vector(3, 4)    >>> abs(v)    5.0
Scalar multiplication::
    >>> v * 3    Vector(9, 12)    >>> abs(v * 3)    15.0
"""

import math
class Vector:
    def __init__(self, x=0, y=0):        self.x = x        self.y = y
    def __repr__(self):        return f'Vector({self.x!r}, {self.y!r})'
    def __abs__(self):        return math.hypot(self.x, self.y)
    def __bool__(self):        return bool(abs(self))
    def __add__(self, other):        x = self.x + other.x        y = self.y + other.y        return Vector(x, y)
    def __mul__(self, scalar):        return Vector(self.x * scalar, self.y * scalar)
除了熟悉的 __init__,我们实现了五个特殊方法。注意:它们没有一个是在类内部被直接调用的,在 doctest 展示的典型用法里也没有。前面说过,大多数特殊方法唯一频繁的调用者就是 Python 解释器。
例 1-2 实现了两个运算符:+ 和 *,用来展示 __add__ 与 __mul__ 的基本用法。两种情况下方法都创建并返回一个新的 Vector 实例,不修改任何操作数——self 和 other 都只被读取。这是中缀运算符应有的行为:造新对象,别动操作数。第 16 章会详细展开这点。
警告:按例 1-2 的实现,Vector 可以乘一个数,但数不能乘 Vector,这违反了标量乘法的交换律。第 16 章我们会用特殊方法 __rmul__ 修好。
下面讨论 Vector 里其余的特殊方法。
__repr__ 特殊方法由内置函数 repr 调用,用来拿到对象供检视的字符串表示。没有自定义 __repr__ 时,Python 控制台会显示成 <Vector object at 0x10e100070>。
交互式控制台和调试器会对求值结果调 repr;老式 % 格式化里的 %r 占位符、以及 f-string 和 str.format 里新格式语法的 !r 转换字段,也会调 repr。
注意我们 __repr__ 里的 f-string 用了 !r 来拿到属性的标准表示。这是好习惯,因为它能显示出 Vector(1, 2) 和 Vector('1', '2') 的关键差异——后者在这个例子的语境下是错的,因为构造器参数应该是数字,不是 str。
__repr__ 返回的字符串应该是无歧义的,并且尽可能和重新创建该对象的源码一致。所以我们的 Vector 表示看起来就像在调用该类的构造器(Vector(3, 4))。
相对地,__str__ 由内置函数 str() 调用,print 函数也会隐式使用它。它应返回适合展示给最终用户的字符串。有时候 __repr__ 返回的字符串就已经足够友好,你就不必写 __str__,因为从 object 类继承的实现会把 __repr__ 当兜底。例 5-2 是书里几个写了自定义 __str__ 的例子之一。
提示:以前用过有 toString 方法语言的程序员,倾向于实现 __str__ 而不实现 __repr__。在 Python 里,如果这两个只实现一个,请选 __repr__。
“Python 里 __str__ 和 __repr__ 有什么区别?“是个 Stack Overflow 问题,Pythonista Alex Martelli 和 Martijn Pieters 在上面有非常精彩的回答。
自定义类型的布尔值
Section titled “自定义类型的布尔值”虽然 Python 有 bool 类型,但任何对象都能用在布尔语境里,比如控制 if 或 while 语句的表达式,或者 and、or、not 的操作数。要判断值 x 是“真”还是“假”,Python 会施加 bool(x),返回 True 或 False。
默认情况下,用户定义类的实例都算“真”,除非实现了 __bool__ 或 __len__。基本上 bool(x) 会调 x.__bool__() 并使用其结果。如果没实现 __bool__,Python 会尝试调 x.__len__();如果它返回 0,bool 返回 False,否则返回 True。
我们的 __bool__ 实现概念上很简单:向量模为 0 返回 False,否则 True。我们用 bool(abs(self)) 把模转成布尔值,因为 __bool__ 被期望返回布尔值。在 __bool__ 方法之外,几乎没必要显式调用 bool(),因为任何对象都能用在布尔语境里。
注意特殊方法 __bool__ 让你的对象遵循《Python 标准库》文档 “Built-in Types” 一章定义的真值测试规则。
注意:Vector.__bool__ 有个更快的实现:
def __bool__(self): return bool(self.x or self.y)它更难读,但省掉了经过 abs、__abs__、平方和开方的过程。显式转 bool 是必要的,因为 __bool__ 必须返回布尔值,而 or 会原样返回某个操作数:x or y 在 x 为真时求值为 x,否则结果是 y,不论 y 是什么。
集合 API
Section titled “集合 API”图 1-2 记录了语言中最基本集合类型的接口。图中所有类都是 ABC——抽象基类(abstract base classes)。ABC 和 collections.abc 模块在第 13 章讲。本节的目标是给出 Python 最重要集合接口的全景,展示它们是如何由特殊方法搭起来的。
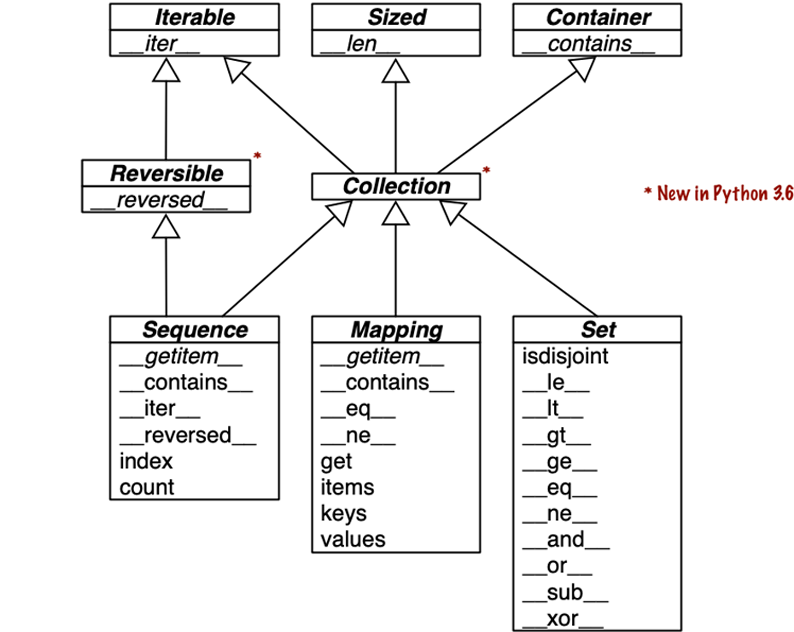
顶层每个 ABC 都对应一个特殊方法。Collection ABC(Python 3.6 新增)统一了每个集合都该实现的三个基本接口:
Iterable,支持for、解包和其他形式的迭代Sized,支持内置函数lenContainer,支持in运算符
Python 并不要求具体类真的继承这些 ABC。任何实现了 __len__ 的类都满足 Sized 接口。
Collection 有三个非常重要的特化:
Sequence,形式化list、str这类内置类型的接口Mapping,由dict、collections.defaultdict等实现Set,set和frozenset内置类型的接口
只有 Sequence 是 Reversible 的,因为序列支持内容任意排序,而映射和集合不行。
注意:从 Python 3.7 起,dict 类型官方说法是“有序的”,但这只意味着键的插入顺序被保留。你不能随意重排 dict 里的键。
Set ABC 里所有特殊方法都实现中缀运算符。例如 a & b 计算集合 a 和 b 的交集,由 __and__ 特殊方法实现。
接下来两章会详细讲标准库的序列、映射和集合。现在我们看 Python 数据模型里定义的主要特殊方法类别。
完整的特殊方法清单和运算符对照表在 特殊方法速查。
为什么 len 不是方法
Section titled “为什么 len 不是方法”2013 年我问过核心开发者 Raymond Hettinger 这个问题,他答案的关键是引用《Python 之禅》里的一句:“实用性胜过纯粹”(practicality beats purity)。
在“特殊方法是怎么被使用的”一节里,我讲过当 x 是内置类型实例时,len(x) 跑得非常快。对 CPython 的内置对象来说根本不调用方法:长度直接从 C 结构体的字段里读出来。取集合中元素个数是极其常见的操作,对 str、list、memoryview 这些既基础又多样的类型,必须高效。
换句话说,len 不以方法形式被调用,是因为它作为 Python 数据模型的一部分得到了特殊待遇,和 abs 一样。但多亏了特殊方法 __len__,你也能让 len 作用于自己的对象。这是“内置对象要高效”和“语言要一致”之间一个公道的折中。《Python 之禅》里还有一句:“特例不足以特殊到打破规则”(Special cases aren’t special enough to break the rules)。
注意:如果你把 abs 和 len 看成一元运算符,可能就更容易接受它们函数式的外观,而不去期待面向对象语言里那种方法调用语法。事实上,ABC 语言——Python 的直接祖先,它开创了 Python 的许多特性——有一个 # 运算符,就相当于 len(你会写 #s)。当它作中缀运算符写成 x#s 时,是数 x 在 s 里出现的次数;在 Python 里,对任意序列 s,你用 s.count(x)。
通过实现特殊方法,你的对象能表现得像内置类型,从而支持社区认为“Pythonic”的那种富有表现力的写法。
Python 对象的一项基本要求是能提供可用的字符串表示:一个用于调试和日志,一个用于展示给最终用户。这就是数据模型里存在 __repr__ 和 __str__ 的原因。
像 FrenchDeck 那样模拟序列,是特殊方法最常见的用途之一。比如数据库库经常把查询结果包在类序列的集合里返回。充分利用现有序列类型是第 2 章的主题;实现你自己的序列在第 12 章讲,那里我们会给 Vector 类做多维扩展。
多亏运算符重载,Python 提供了丰富的数值类型选择,从内置类型到 decimal.Decimal 和 fractions.Fraction,全都支持中缀算术运算符。NumPy 数据科学库对矩阵和张量也支持中缀运算符。实现运算符——包括反向运算符和增强赋值——会在第 16 章通过对 Vector 例子的增强来展示。
Python 数据模型里其余大多数特殊方法的使用与实现,会贯穿本书讲完。
- 《Python 语言参考》的 “Data Model” 一章,是本章乃至本书大部分内容的权威来源。
- Alex Martelli、Anna Ravenscroft、Steve Holden 合著的 Python in a Nutshell 第 3 版(O’Reilly)对数据模型讲得极好。除了 CPython 的 C 源码本身,他们对属性访问机制的描述是我见过最权威的。
- Martelli 也是 Stack Overflow 的高产贡献者,发过 6200 多个回答。
- David Beazley 有两本书在 Python 3 语境下详讲数据模型:Python Essential Reference 第 4 版(Addison-Wesley),以及与 Brian K. Jones 合著的 Python Cookbook 第 3 版(O’Reilly)。
- Gregor Kiczales、Jim des Rivieres、Daniel G. Bobrow 的 The Art of the Metaobject Protocol(MIT Press)解释了“元对象协议”这一概念,Python 数据模型就是它的一个例子。
高谈阔论(Soapbox)
Section titled “高谈阔论(Soapbox)”数据模型还是对象模型?
Section titled “数据模型还是对象模型?”Python 文档叫“Python Data Model”(Python 数据模型)的东西,大多数作者会说是“Python 对象模型”。Martelli 等人的 Python in a Nutshell 第 3 版和 David Beazley 的 Python Essential Reference 第 4 版是讲 Python 数据模型最好的书,但他们都称之为“对象模型”。
维基百科上“对象模型”的第一条定义是:“在某个特定计算机编程语言中,对象的一般性质。“这正是 Python 数据模型讲的东西。
本书用“数据模型”,因为文档在指 Python 对象模型时偏好这个词,也因为它是《Python 语言参考》里和我们的讨论最相关的那一章的标题。
麻瓜方法(Muggle Methods)
Section titled “麻瓜方法(Muggle Methods)”《原版黑客词典》把 magic 定义为“尚未解释,或复杂到无法解释”或“一种通常不公开、但能让本来做不到的事成为可能的功能”。
Ruby 社区把对应的特殊方法叫 magic methods(魔法方法),Python 社区里也有很多人跟着这么叫。
我认为特殊方法恰恰是 magic 的反面。Python 和 Ruby 用一套完整文档化的、丰富的元对象协议来赋权用户,让像你我这样的麻瓜也能模拟出语言核心开发者才能用的许多特性。
对比一下 Go。Go 里有些对象带着“魔法”特性——意思是我们在自己定义的类里模拟不出来。比如 Go 的数组、字符串和 map 支持用方括号取元素,写成 a[i],但你没办法让你定义的新集合类型也用上 [] 记法。
更糟的是,Go 没有用户层面的可迭代接口或迭代器对象的概念,所以它的 for/range 语法只支持五种“魔法”内置类型,包括数组、字符串和 map。
也许将来 Go 的设计者会增强它的元对象协议。但目前,它比 Python 或 Ruby 里有的东西受限得多。
元对象(Metaobjects)
Section titled “元对象(Metaobjects)”The Art of the Metaobject Protocol(AMOP)是我最喜欢的计算机书书名。我提它,是因为“元对象协议”(metaobject protocol)这个说法,对思考 Python 数据模型和其他语言里的类似特性很有用。
“元对象”(metaobject)指的是那些构成语言本身的积木块的对象。在这个语境里,“协议”(protocol)是“接口”的同义词。所以元对象协议就是对象模型的华丽同义词:一套面向核心语言构造的 API。
一套丰富的元对象协议能让语言被扩展、去支持新的编程范式。AMOP 一书的第一作者 Gregor Kiczales 后来成了面向切面编程(AOP)的先驱,也是 AspectJ 的最初作者——AspectJ 是 Java 的一个扩展,实现了该范式。
面向切面编程在 Python 这种动态语言里实现起来容易得多,有些框架就这么做。最重要的例子是 zope.interface,它是 Plone 内容管理系统所基于的框架的一部分。
脚注
- “Story of Jython”,为 Samuele Pedroni 和 Noel Rappin 的 Jython Essentials(O’Reilly)所写的序言。
- C 结构体(struct)是一种带命名字段的记录类型。